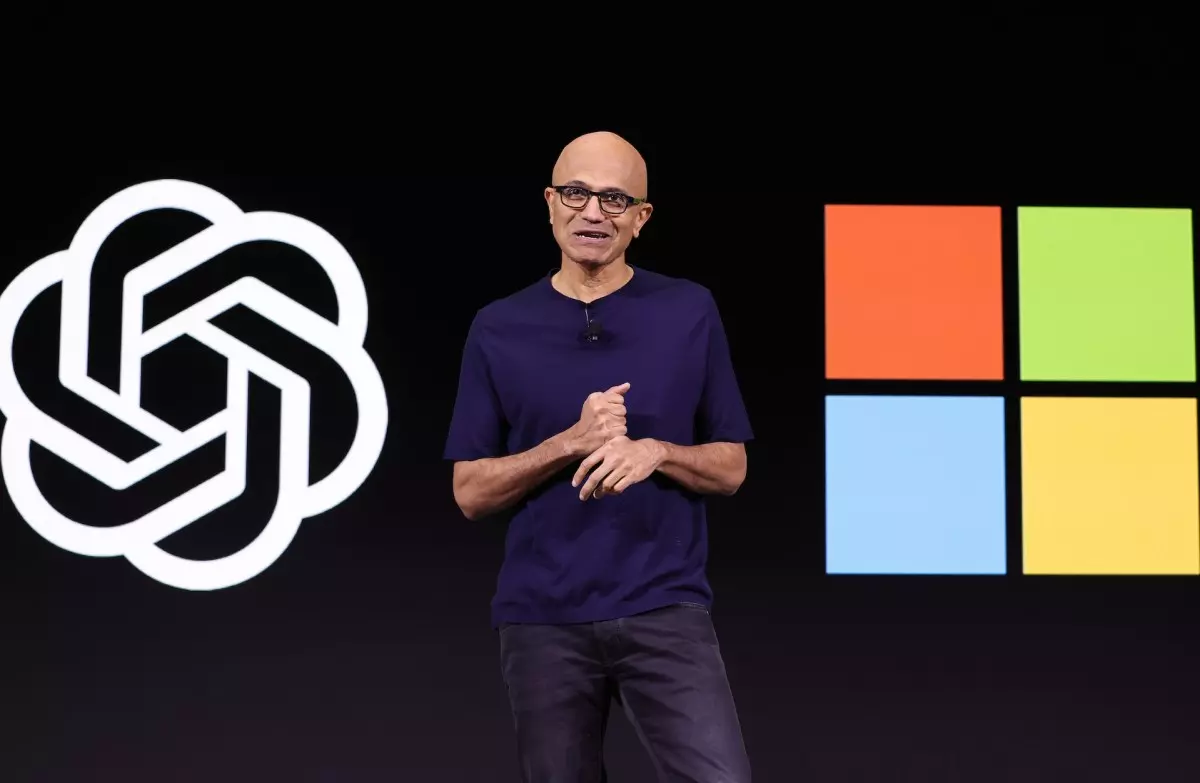
В рамках судебного иска о нарушении авторских прав, поданного The New York Times против OpenAI и Microsoft, стали известны новые неотредактированные материалы. Они показывают, что представители компаний признавали: массовый сбор данных для обучения ИИ (искусственного интеллекта) по сути является кражей. Кроме того, в документах указано, что продукты на базе ИИ представляют серьёзную угрозу для изданий. Об этом сообщает TechCrunch.
Согласно материалам дела, один из высокопоставленных руководителей Microsoft в частном порядке называл методы обучения ИИ компаний «кражей». Руководство OpenAI, в свою очередь, заявляло, что их модели ИИ создают «экзистенциальную угрозу» для издателей и журналистов, чьи работы использовались для их обучения. В рассекреченных документах также описано, как компании, предположительно, получали и использовали этот контент: обходили платные подписки (paywall) незаметно, создавали обучающие наборы данных путём массового сбора информации и намеренно удаляли уведомления об авторских правах из обучающих данных.
Значительная часть новой информации взята из собственного судебного заключения The New York Times, а не из первичных доказательств, которые остаются засекреченными. Приведённые цитаты даны без исходного контекста. Этот неотредактированный документ — последняя эскалация в трёхлетнем судебном процессе, в котором The New York Times изначально обвинила компании в нарушении авторского права путём обучения генеративных моделей ИИ на её контенте. Вопрос о том, могут ли ИИ-компании на законных основаниях использовать защищённые авторским правом материалы для обучения ИИ, не имеет однозначного ответа, но судьи в основном поддерживают аргументы ИИ-компаний о том, что обучение подпадает под «добросовестное использование» (fair use). Это правовое правило позволяет в определённых случаях использовать защищённые авторским правом работы без разрешения, например, для пародии, новостных репортажей или критики. Ранее в этом месяце администрация Трампа представила заключение в защиту нелицензионного использования OpenAI защищённых авторским правом материалов для обучения своих больших языковых моделей (LLM).
Однако несколько новых признаний противоречат аргументу OpenAI о добросовестном использовании, особенно требованию, чтобы использование не заменяло и не наносило ущерб рынку оригинальной работы. Например, собственные данные Microsoft показывают, что её «движок ответов» Copilot привёл к падению показателя кликабельности (click-through rate) для домена The New York Times на целых 93% по сравнению с традиционным поиском Bing. Внутренняя презентация Microsoft, написанная директором по прикладной науке Брентом Хехтом в январе 2024 года, описывает это снижение как «петлю гибели» (doom loop), которая «навредит производительности наших моделей и всей сети одновременно». «Крайне необычно, когда конечный продукт угрожает экономическим основам своих ключевых поставщиков, но именно такую ситуацию мы создали для нашего бизнеса LLM в отношении его «цепочки поставок контента»», — говорится в документе Microsoft, цитируемом в заключении.
Генеральный директор Microsoft Сатья Наделла также заявил в ходе дачи показаний ранее в этом году, что «всё, что находится за платной подпиской, должно быть лицензировано любым желающим использовать это… для обоснования или обучения», и дал понять, что, если бы он «был осведомлён, что OpenAI собирала и обучалась на информации, находящейся за платной подпиской», он бы «воспользовался [правом Microsoft] потребовать от OpenAI переобучить свои модели». Другие признания противоречат иным столпам теста на добросовестное использование: руководитель ChatGPT в OpenAI Ник Тёрли написал во внутренней переписке, что издатели сталкиваются с «экзистенциальной угрозой» от таких продуктов, как чат-бот, которые «в значительной степени замещают» оригинал и «будут замещать всё больше по мере совершенствования». Президент OpenAI Грег Брокман описывал модели как «отлично справляющиеся с новостями». Наделла под присягой ранее в этом году согласился, что общение с чат-ботами «заменило… предоставление информации прямо на сайте на платформе ИИ вместо необходимости переходить к первоисточнику».
Подобные формулировки говорят о том, как технология может напрямую конкурировать с оригинальной работой, а не преобразовывать её. В документе Microsoft указано, что существует «реальный риск» того, что генеративный ИИ может «значительно нарушить занятость тех самых людей, которые создали данные, на которых обучалась базовая модель». Масштаб копирования поражает: документы впервые раскрывают, что только промежуточные обучающие наборы данных OpenAI содержат более 91 692 копий произведений, опубликованных NYT, Daily News и Center for Investigative Reporting. Набор данных, производный от Common Crawl, включал более 2 миллионов документов только с nytimes.com. В внутренней записке от января 2023 года Хехт назвал это «ошеломляющей кражей беспрецедентных масштабов» и «крупнейшей кражей труда в истории человечества». В заключении подробно описывается, как OpenAI и Microsoft приобретали контент истцов, в том числе путём сбора его из индекса Bing. «OpenAI передала весь обучающий набор данных GPT-3 компании Microsoft, которая использовала его для оценки того, как внедрить модели OpenAI в свои коммерческие продукты», — говорится в заключении. «Microsoft аналогичным образом предоставляла обучающие данные OpenAI через инициативы под названием Project Taxi и Project Mango». Компании, как утверждается, собрали данные Project Mango в обучающий набор, содержащий копии как минимум 160 903 уникальных произведений новостных издателей.
Чтобы извлечь максимум из сбора данных, сотрудники OpenAI, как утверждается, разработали план обхода платных подписок без обнаружения. Материалы дела показывают, что когда исследователь OpenAI Ник Райдер рассказал Брокману о «взломе для обхода платной подписки nytimes», Брокман ответил: «а, отлично». Сотрудники OpenAI также, предположительно, создавали обучающие наборы данных, такие как WebText и WebText2, которые непропорционально сильно опирались на собранный новостной контент. Они также, как утверждается, извлекали миллионы статей из Common Crawl — бесплатного открытого хранилища данных веб-сканирования. В выводах также описываются намеренные усилия по удалению уведомлений об авторских правах из обучающих данных до того, как они попадали в модель, поскольку исследователи «не хотели бы, чтобы модель выдавала» «уведомления об авторских правах» пользователям. «Доказательства, впервые раскрытые здесь, показывают, что OpenAI и Microsoft знали, что делают что-то не так», — заявил в комментарии для TechCrunch Стивен Либерман, адвокат New York Daily News. OpenAI и Microsoft не ответили на запросы о комментарии.